
الذكاء الاصطناعي يبني ملفا عنك.. ماذا يحدث لمعلوماتك بعد محادثتك مع الروبوت؟
وكالات
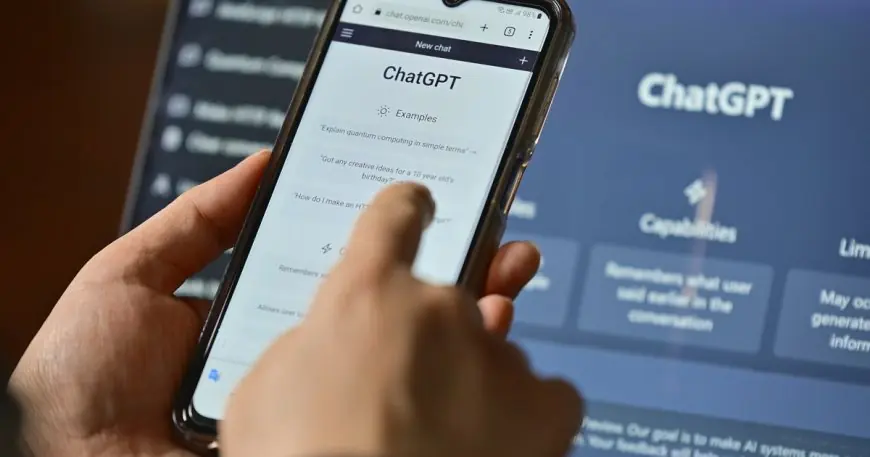
تتسارع المنافسة بين شركات التكنولوجيا لتطوير أنظمة ذكاء اصطناعي قادرة على معرفة أكبر قدر ممكن من التفاصيل المتعلقة بالمستخدمين، وهو ما يطرح تساؤلات متزايدة حول مصير المعلومات التي يتم مشاركتها مع هذه الأنظمة، ومدى وعي المستخدمين بطبيعة البيانات التي يوافقون على مشاركتها بمجرد بدء التفاعل مع روبوتات المحادثة.
وحاول تقرير حديث نشره موقع «Axios» تسليط الضوء على هذه الإشكالية، موضحا أن شركات التكنولوجيا لا تتعامل مع بيانات المستخدمين بالطريقة نفسها، خصوصا في ظل عدم وجود قواعد قانونية واضحة وموحدة تنظم هذا المجال. ففي الوقت الذي تستفيد فيه بعض الشركات من البيانات لتقديم ردود أكثر تخصيصا، تستخدمها شركات أخرى في تدريب أنظمتها أو في توجيه إعلانات تتناسب مع اهتمامات المستخدمين.
تتبنى شركة «آبل» هذا النموذج، إذ تحاول معالجة طلبات المستخدم على هاتفه أو جهازه قدر الإمكان، بما يسمح بإبقاء البيانات داخل الجهاز وعدم إرسالها إلى الخارج. وفي الحالات التي تتطلب قدرة معالجة أكبر، تلجأ الشركة إلى نظام سحابي خاص بها، وتؤكد أن البيانات تستخدم فقط لمعالجة الطلب الحالي قبل التخلص منها مباشرة. غير أن هذا المستوى من الخصوصية لا ينطبق عند اختيار خدمات خارجية، مثل ChatGPT، من خلال أجهزة «آبل».
تعتمد شركة «ميتا» نهجا أكثر توسعا، إذ تمنح نفسها صلاحيات واسعة للاستفادة من محادثات المستخدمين مع مساعدها الذكي Meta AI من أجل تخصيص الإعلانات والمحتوى الذي يظهر لهم عبر «فيسبوك» و«إنستغرام»، وكذلك من خلال نظاراتها الذكية. وفي المقابل، تؤكد الشركة أنها لا تستعمل المحادثات المتعلقة بمواضيع حساسة، مثل الصحة والسياسة والدين، لهذا الغرض. كما طرحت مؤخرا خيارا للمحادثات الخاصة المؤقتة، يتيح حذف البيانات مباشرة، بهدف توفير مستوى إضافي من التحكم للمستخدم.
تندرج غالبية خدمات الذكاء الاصطناعي الأخرى ضمن هذا النموذج، حيث توفر مزيجا من الخيارات المتعلقة بالخصوصية والبيانات. فهناك خدمات تتيح إجراء محادثات مؤقتة لا يتم الاحتفاظ بها، وأخرى تشترط موافقة المستخدم بشكل صريح قبل استخدام بياناته، في حين تعتمد بعض الخدمات الموافقة التلقائية ما لم يطلب المستخدم عدم المشاركة.
وتختلف كذلك وسائل التحكم في البيانات من خدمة إلى أخرى؛ إذ تسمح بعض التطبيقات للمستخدم بإبلاغ المساعد مباشرة بعدم الاحتفاظ بمعلومة محددة، بينما تفرض تطبيقات أخرى الدخول إلى إعدادات متعددة ومعقدة للتحكم في المعلومات التي يتذكرها النظام عن المستخدم.
ويشير التقرير إلى أن السؤال الأساسي لم يعد يقتصر على معرفة ما إذا كانت الشركة تستخدم بيانات المستخدم لتدريب أنظمة الذكاء الاصطناعي، وإنما أصبح يتعلق بكيفية بناء النظام لفهم شامل عن المستخدم، وما الذي يمكن أن يفعله بهذه المعرفة مستقبلا.
فشركات التكنولوجيا لم تعد تجمع البيانات بهدف تطوير أنظمتها فقط، بل أصبحت تعمل على تكوين صورة أو ملف شخصي عن كل مستخدم، يمكن توظيفه لتحسين جودة الردود، وزيادة مدة التفاعل والمحادثات، وربما التأثير في اختيارات المستخدم وآرائه، وصولا إلى دفعه نحو شراء منتجات معينة.
وفي هذا السياق، يتجه الذكاء الاصطناعي الموجه للمستهلكين نحو نموذج يشبه ما عرفته محركات البحث ومنصات التواصل الاجتماعي، حيث تشكل الإعلانات أحد أهم مصادر الإيرادات.
وتبحث شركات كبرى، من بينها «غوغل» و«ميتا» وOpenAI، في إمكانية إدماج الإعلانات داخل روبوتات المحادثة، وهو ما قد يعزز الدافع إلى جمع المزيد من المعلومات المتعلقة بالمستخدمين بهدف تحسين استهداف الإعلانات.
وتحذر ميراندا بوغن، المتخصصة في قضايا التكنولوجيا لدى مركز الديمقراطية والتكنولوجيا، من أن الذكاء الاصطناعي قد يعتمد بشكل متزايد على استعداد الأشخاص لتسليم جزء كبير من حياتهم الرقمية لهذه الأدوات بصورة طوعية. وترى أن زيادة حجم المعلومات التي يعرفها النظام عن المستخدم قد تجعل من السهل عليه طلب تفاصيل أكثر خصوصية منه بطريقة تبدو طبيعية أثناء الحوار.
وتؤكد بوغن في ختام موقفها أن الحصول على مساعد شخصي ذكي قد يكون، بالنسبة إلى كثير من الأشخاص، مقابلا مقبولا للتنازل عن جزء من الخصوصية، لكنها تشدد في الوقت نفسه على ضرورة أن يكون المستهلك على دراية كاملة بطبيعة هذه المقايضة قبل بدء استخدام الخدمة، وليس بعد فوات الأوان.
ويبقى السؤال المطروح هو ما إذا كان المستخدمون سيحتفظون فعلا بالقدرة على تحديد كيفية استخدام بياناتهم ومصيرها، أم أن خوارزميات الذكاء الاصطناعي ستفرض تدريجيا قواعد جديدة للخصوصية في ظل سباق متواصل نحو مزيد من التخصيص.